1. Vision Transformer 란?
Vision Transformer(ViT)는 Transformer구조를 이미지 처리에 적용하기 위해 나온 기술이다. Transformer는 원래 Sequence 데이터를 처리하기 위해 나온 모델이지만 이미지 데이터는 문장처럼 Sequence 데이터가 아니기 떄문에 이미지를 Transformer가 처리 할 수 있는 sequence로 변환해야 한다.
2. Image Patch
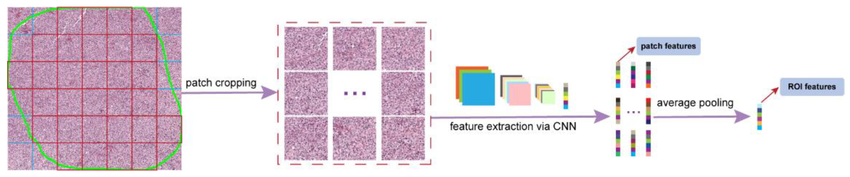
Coursera 강의를 들을 때 배웠던 내용이라 짧게만 설명하고 넘어가겠다. 예를 들어 이번 프로젝트에 쓸 데이터인 CIFAR-10 이미지를 보면 32x32x3 형태의 데이터로 돼 있는데 이 이미지를 nxn 짜리의 window를 통해 잘라주는 것이다. 만약 window가 4x4 라면 32/4 = 8 총 가로 8개 세로 8개로 8x8=64개의 작은 이미지 조각이 생기는 것이다. 우리가 NLP에서 문장을 토큰화 해서 하나의 토큰을 Transformer의 입력 단위로 사용했던 것 처럼 ViT 에서는 작은 이미지 조각인 Patch를 입력 단위로 사용하는 것이다. 위 이미지와 같이 보면 이해하기 쉬울 것이다.
3. CIFAR-10 Dataset
transform = transforms.ToTensor()

train_dataset = torchvision.datasets.CIFAR10(
    root="./data",
    train=True,
    download=True,
    transform=transform
)

image, label = train_dataset[0]

print(image.shape)
print(label)
torch.Size([3, 32, 32])
6- image : 모델에 들어갈 이미지 (3 x 32x 32 구조)
- label : 해당 이미지의 정답클래스 (0 -> airplane 1-> automobile ... )
4. unfold()를 이용한 Patch Split
patch_size = 4

patches = image.unfold(1, patch_size, patch_size)
patches = patches.unfold(2, patch_size, patch_size)

print(patches.shape)
torch.Size([3, 8, 8, 4, 4])unfold(dimension, size, step)
dimension : 어느 축을 자를 것인지
size : 한 조각의 크기
step : 몇 칸씩 이동할 것인지
각각 세로와 가로로 잘라야하기 때문에 지금은 두번 unfold 해 줬다.
사실 이것도 바로 잘라주는 tool이 있긴 하지만 굳이 사용하지는 않았다.
5. permute(), reshape로 Vector변환
앞선 결과 값을 보면 현재 patches의 값은 [C,H,W,Ph,Pw] 로 이루어져 있음을 알 수 있다. 하지만 우리는 결국 Transformer에 넣기 위해서 Vector값으로 바꿔야 하기 때문에 (Patch 개수, Patch 하나의 크기) 로 바꿔 줄 필요가 있다.
patches = patches.permute(1, 2, 0, 3, 4)[8, 8, 3, 4, 4]이렇게 바뀌게 되고
patches = patches.reshape(64, 48)Patch의 개수 8x8 = 64, Patch 하나의 크기 3x4x4 = 48 이기 때문에 이 모양대로 reshape 시켜주면 하나의 이미지를 64개의 48차원 벡터로 변환이 끝난다.
'컴붕이의 감자 탈출기 > 함부로 딥러닝에게 덤비기' 카테고리의 다른 글
| 분류 모델 성능 평가 지표(Confusion_matrix, Precision, Recall, F1-Score) (0) | 2026.09.12 |
|---|---|
| [Hugging Face] Pre-trained Model Fine-tuning (3. Train Loss vs Validation Loss) (1) | 2026.09.06 |
| [Hugging Face] Pre-trained Model Fine-tuning (2. Fine-tuning) (1) | 2026.09.02 |
| [Hugging Face] Pre-trained Model Fine-tuning (1. 데이터 셋 준비하기) (0) | 2026.08.30 |
| [HuggingFace]Text_Generation(Decoder-only) (0) | 2026.08.29 |

