1. VLM이란?
VLM(Vision Language Model)은 Computer Vision 과 NLP 기능을 결합한 AI모델을 말한다.
기존의 Vision 모델은 이미지만 입력으로 받아 분류나 객체인식과 같은 작업을 수행하고, NLP모델은 텍스트를 입력으로 받아 문장을 이해하거나 생성한다.
하지만 이 둘을 함께 사용할 수는 없었다. 예를 들어 강아지 사진을 넣는다면 Vision 모델에서 강아지를 구별 할 수는 있지만 '뛰고 있는 강아지'와 '자고 있는 강아지'를 구별하고 이를 설명하라고 시키면 못한다는 것이다.
이를 해결한 모델이 VLM으로 서로 다른 형태의 데이터인 Vision과 Language를 하나의 모델 안에서 연결한다.
대표적인 모델로 CLIP과 LLaVA에 대해 알아보자.
2. CLIP
CLIP은 이미지와 텍스트를 각각 처리하기 위해 두 개의 encoder를 사용한다.
Image → Image Encoder → Image Embedding
                              ↘
                             비교
                              ↗
Text  → Text Encoder  → Text Embedding
Image Encoder로 이미지를 vector로 만들고, Text Encoder를 이용해 텍스트를 vector로 전환한다.
그리고 CLIP은 서로 대응되는 이미지와 텍스트의 embedding은 가까워지도록, 서로 관련 없는 이미지와 텍스트의 embedding은 멀어지도록 학습한다.
예를 들어 강아지 이미지와 "a photo of a dog" 라는 텍스트가 한 쌍으로 주어졌다고 하자.
학습이 잘 이루어졌다면 강아지 이미지의 embedding은 "a photo of a dog"의 embedding과 가까워져야 한고
반대로 "a photo of a car"와 같은 전혀 관련이 없는 텍스트와는 멀어져야 한다.
이러한 방식으로 CLIP은 이미지와 자연어 사이의 의미적 관계를 학습하는 방식이다.
3. Image와 Text를 같은 Embedding Space로 보내기
앞서 말했듯 이미지와 텍스트는 먼저 서로 다른 encoder를 통과하게 된다.
이미지는 Image Encoder를 사용한다.
Image
[B, 3, H, W]

↓

Image Encoder

↓

Image Feature [B,A]
여기에는 ViT와 같은 Vision Encoder를 사용할 수 있고 ResNet과 같은 일반적인 CNN 모델도 활용 할 수 있다.
즉 CLIP의 구조에서 이미지와 텍스트의 Encoder로 어떤 모델을 사용하던 상관이 없다는 뜻이다. 향후 ViT보다 더 강력한 Vision모델이 나온다면 Encoder만 그대로 갈아끼우면 되는 것이다.
텍스트도 별도의 Text Encoder를 통과한다.
Text
[B, Sequence Length]

↓

Text Encoder

↓

Text Feature [B,C]
여기서 두 Encoder가 다른 model이기 때문에 각각의 feature들이 다른 차원을 가지고 있다. 하지만 둘을 비교하기 위해선 같은 차원으로 만들어줘야 하기 때문에 각각의 feature에 Projection Layer를 적용하여 같은 차원으로 만들어준다.
Image Feature
     ↓
Projection
     ↓
Image Embedding [B, D]
Text Feature
↓
Projection
↓
Text Embedding [B, D]두 feature를 모두 같은 D차원의 vector로 바꾸면서 이미지와 텍스트를 공통된 embedding space에 표현할 수 있게 된다.
이후 두 embedding은 normalize한 뒤 cosine similarity를 계산하여 두 vector의 유사도를 나타내게 된다.
여기까지는 이미지 하나와 텍스트 하나를 비교하는 구조처럼 보인다.
하지만 CLIP의 실제 학습에서 중요한 점은 batch 안의 모든 이미지와 모든 텍스트를 서로 비교한다는 것이다. 그래야 더 세부적인 문맥까지 파악을 할 수 있게 된다. 예를 들어
Image 1 : 달리는 강아지
Text 1  : "a dog running"

Image 2 : 잠자는 강아지
Text 2  : "a dog sleeping"

Image 3 : 달리는 고양이
Text 3  : "a cat running"
이런 데이터가 있다고 하면 Image 1 입장에서는
"a dog running"  → 가장 가까워져야 함
"a dog sleeping" → 같은 강아지지만 행동이 다름
"a cat running"  → 행동은 같지만 객체가 다름
이렇게 동시에 비교하게 되는 것이다. 따라서 모델은 단순히 강아지사진 == dog 정도만 학습하는 것이 아닌 더 세부적인 의미 차이를 representation에 반영하게 되는 것이다.
4. [B, B] Similarity Matrix
앞서 cosine similarity를 계산하면 [B,B] Matrix가 나온다.
예를 들어 각 이미지와 텍스트를 encoder와 projection layer에 통과시키면 다음과 같은 embedding을 얻는다고 하자.
Image Embedding : [4, D]
Text Embedding  : [4, D]
여기서 모든 image와 모든 text의 similarity를 한 번에 계산한다.
Text Embedding을 transpose하여 Image Embedding과 행렬곱을 수행하면
[4, D] @ [D, 4]
=
[4, 4]
형태의 matrix가 만들어진다. (cosine similarity 과정이다.)
이렇게 나오는 matrix가 CLIP의 Similarity Matrix이다.
예를 들어 결과가 다음과 같다고 생각해보자.
| Text 1 | Text 2 | Text 3 | Text 4 | |
| Image1 | 8.2 | 1.1 | 0.5 | 2.0 |
| Image2 | 0.9 | 7.8 | 1.0 | 0.3 |
| Image3 | 0.4 | 1.2 | 8.5 | 0.7 |
| Image4 | 1.3 | 0.5 | 0.8 | 7.6 |
여기서 중요한 부분은 대각선이다.
Image1 ↔ Text1
Image2 ↔ Text2
Image3 ↔ Text3
Image4 ↔ Text4
이 pair들은 실제로 서로 대응되는 image-text pair이므로 Positive Pair가 된다.
반면
Image1 ↔ Text2
Image1 ↔ Text3
Image2 ↔ Text4
...
처럼 대각선이 아닌 조합들은 서로 대응되지 않는 Negative Pair이다.
따라서 CLIP이 원하는 similarity matrix의 모습은 자연스럽게
Diagonal       → 높은 similarity
Off-diagonal   → 낮은 similarity
가 되는 것이다.
즉 batch 하나만으로도 각 이미지에 대해 하나의 positive text와 여러 개의 negative text를 동시에 만들 수 있다.
실제로 similarity를 계산하기 전에는 embedding을 normalize하고, 계산된 similarity에는 temperature와 관련된 scale을 적용한다.
5. Contrastive Learning과 CLIP Loss
이제 앞에서 만든 Similarity Matrix를 실제 학습에 사용한다.
CLIP의 목표는 간단하다. Positive Pair는 유사도를 높이고, Negative Pair는 유사노를 낮추면 된다.
Positive Pair → Similarity ↑
Negative Pair → Similarity ↓
이러한 방식으로 서로 비슷한 sample은 가깝게, 서로 다른 sample은 멀어지게 학습하는 방식을 Contrastive Learning이라고 한다.
CLIP에서는 당연하게도 이 학습을 한 방향만 수행하지 않고 Image → Text와 Text → Image 두 방향에서 모두 수행한다.
먼저 Image → Text 방향을 생각해보자.
Similarity Matrix의 첫 번째 row를 보면 다음과 같다.
             Text1   Text2   Text3   Text4

Image1        8.2     1.1     0.5     2.0
Image1 입장에서는 "Image1과 가장 잘 맞는 텍스트는 무엇인가?"를 찾아야하고
정답은 Text1이다.
Image2에서는 Text2, Image3에서는 Text3가 정답이 된다.
따라서 target은 간단히
labels = [0, 1, 2, 3]처럼 만들 수 있고 Cross Entropy Loss를 계산할 수 있다.
다음으로 Text → Image 방향을 생각해보면
Text1
 ↓
Image1 Image2 Image3 Image4
Text1 입장에서는 "Text 1과 가장 잘 맞는 이미지는 무엇인가?" 를 찾는 문제가 된다.
정답은 역시 Image1이다.
따라서 Text → Image 방향에서도 Cross Entropy Loss를 계산한다.
결과적으로 CLIP의 loss는 개념적으로 다음과 같이 표현할 수 있다.
Image → Text Cross Entropy
              +
Text → Image Cross Entropy
              ↓
            평균
즉,
CLIP Loss
=
(Image-to-Text Loss + Text-to-Image Loss) / 2
가 된다.
이렇게 두 방향에서 동시에 학습하기 때문에 이미지는 자신과 대응되는 텍스트를 찾도록 학습되고, 텍스트 역시 자신과 대응되는 이미지를 찾도록 학습된다.
6. 학습이 끝나면 무엇을 얻는가
CLIP 학습의 결과로 얻고 싶은 것은 특정 class를 외운 classifier 자체가 아니다.
핵심은 Image와 Text가 의미적으로 정렬된 Embedding Space이다.
예를 들어 학습이 잘 되었다면
강아지 이미지
      ↘
      가까움
      ↗
"a photo of a dog"
처럼 의미가 비슷한 image와 text가 embedding space에서도 가까운 위치에 존재하게 된다.
반대로
강아지 이미지
      ↘
       멂
      ↗
"a photo of a car"
처럼 의미가 다른 데이터는 더 멀리 떨어지게 된다.
즉 CLIP은 Image와 Text 각각의 정보를 담고 있는 vector를 만들고
두 vector를 같은 공간에서 직접 비교할 수 있도록 학습한 것이다.
이 점이 중요한 이유는 학습이 끝난 뒤 새로운 이미지를 단순히 고정된 class 번호와 비교하는 것이 아니라 자연어와 직접 비교할 수 있기 때문이고 이는 VLM 탄생의 핵심이다.
7. Zero-shot Classification
일반적인 이미지 분류 모델을 생각해보면 학습할 때부터 분류해야 할 class가 정해져 있다.
예를 들어
0 → dog
1 → cat
2 → car
같은 class를 가지고 학습한 모델은 해당 class를 직접 예측하도록 만들어진다.
하지만 CLIP은 이미지와 텍스트를 같은 embedding space에 정렬하도록 학습했다.
따라서 classification도 조금 다른 방식으로 수행할 수 있다.
먼저 새로운 이미지를 Image Encoder에 넣는다.
Input Image
     ↓
Image Encoder
     ↓
Image Embedding
그리고 분류하고 싶은 class를 자연어 형태로 만든다.
예를 들어 후보가 dog, cat, car라면
"a photo of a dog"
"a photo of a cat"
"a photo of a car"
처럼 각각의 class를 text prompt로 만든다.
이 문장들을 Text Encoder에 통과시키면 각각의 Text Embedding을 얻는다.
이제 새로운 이미지의 embedding과 각 text embedding의 similarity를 비교한다.
Input Image

   ↕ similarity

"a photo of a dog" → 0.91
"a photo of a cat" → 0.13
"a photo of a car" → 0.04
가장 높은 similarity를 가진 text를 선택하면 이 경우 결과는 dog가 된다.
여기서 중요한 점은 CLIP이 이 classification task를 위해 별도의 classifier를 다시 학습하지 않았다는 것이다.
그래서 이를 Zero-shot Classification이라고 한다.
이것이 가능한 이유는 CLIP이 학습 과정에서 고정된 정답 label과 이미지의 관계만 학습한 것이 아니라, 이미지와 자연어 사이 의미적 관계를 학습했기 때문이다.
따라서 새로운 class 역시 자연어로 표현할 수 있다면 image embedding과 비교해볼 수 있다.
8. 정리
CLIP의 전체 흐름을 그림으로 정리하면 다음과 같다.
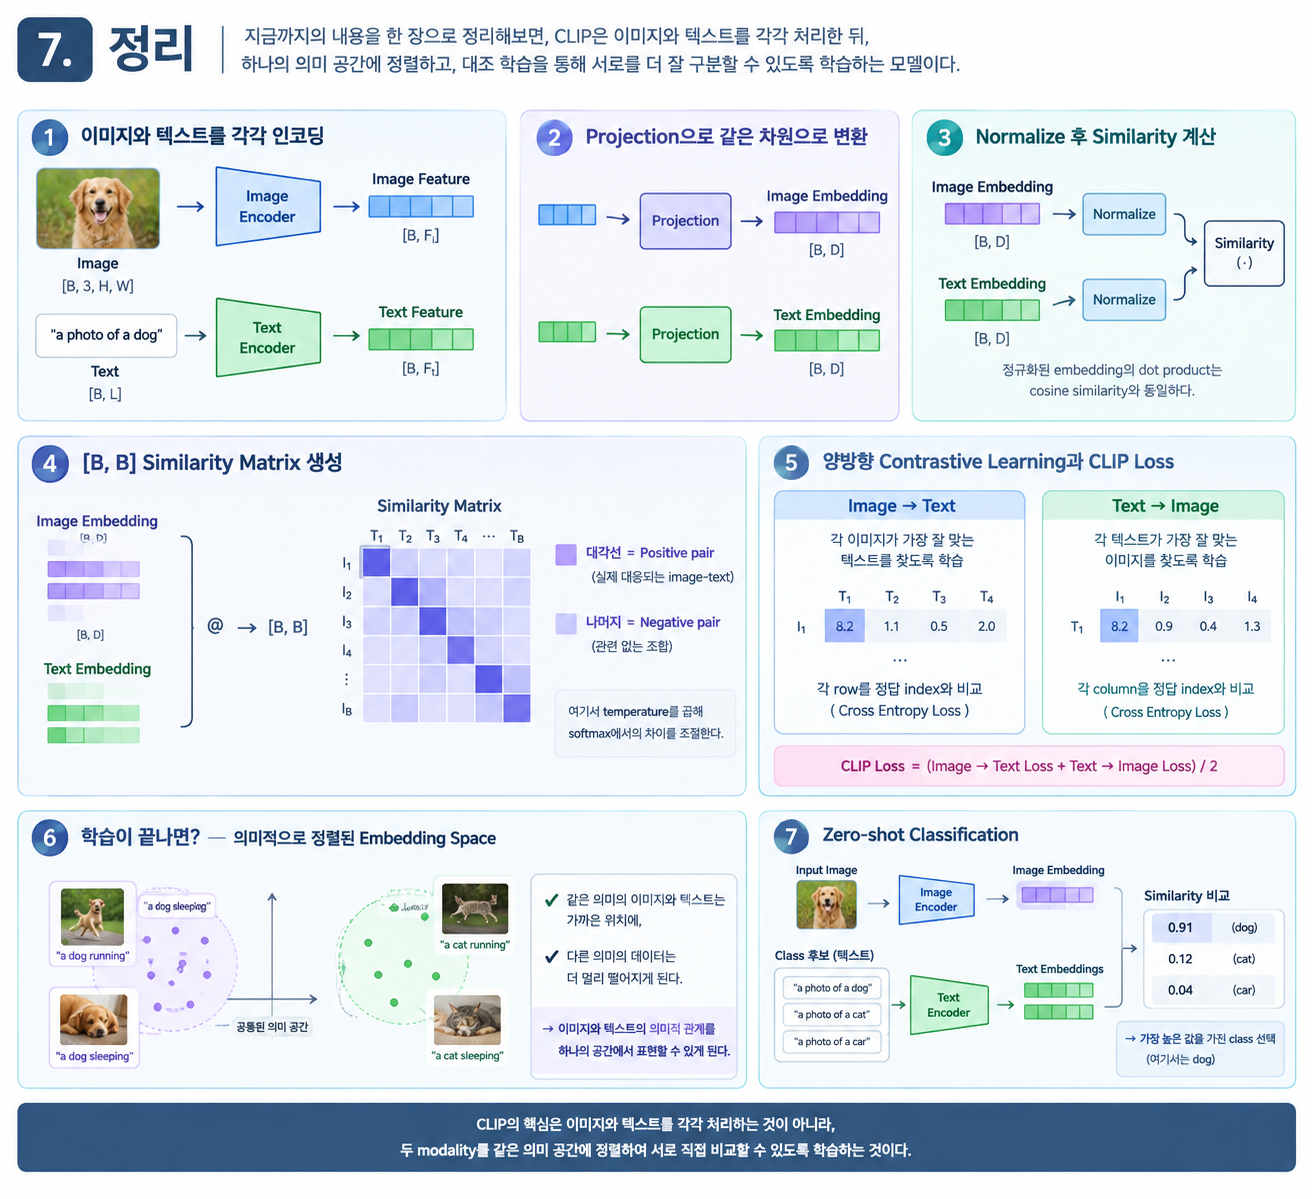
CLIP의 핵심은 이미지와 텍스트를 각각 처리하는 것이 아니라, 두 modality를 같은 의미 공간에 정렬하여 서로 직접 비교할 수 있도록 학습하는 것이라고 할 수 있다.
'컴붕이의 감자 탈출기 > 함부로 딥러닝에게 덤비기' 카테고리의 다른 글
| [DINO]Teacher와 Student로 배우는 Self-Supervised Learning (0) | 2026.10.10 |
|---|---|
| Self-Supervised Learning (자기 지도 학습) (1) | 2026.10.09 |
| [Paper][ViT]An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale 리뷰 (0) | 2026.10.06 |
| [Vision Transformer] 4. Post-LN vs Pre-LN, ReLU vs GELU (0) | 2026.09.27 |
| [Vision Transformer] 3. VisionTransformer 모듈 완성 (0) | 2026.09.25 |


